 Pachat.ai
多个 AI 同时聊:为什么要一起问
更新于 2026-11
TL;DR: 同时聊多个 AI,就是把同一个问题问给不止一个 AI,再对比它们的回答。答案不一致,说明该深挖;答案一致,你的把握就更大。你可以用三个浏览器标签页、多模型工具,或者让 AI 智能体互相核对的群聊来做到。
你有 ChatGPT、Claude 和 Gemini,它们都说自己是最好的。如果你不是技术人员,这些就只是噪音。
什么是同时聊多个 AI?
同时聊多个 AI,是指把同一个问题发给好几个 AI 助手,例如 ChatGPT、Claude 和 Gemini,然后并排阅读它们的回答。到 2026 年,这有 3 种做法:自己管理的浏览器标签页、替你运行多个模型的一个工具,或者让各个助手互相交流的群聊。这 3 种做法都出于同一个顾虑:没有任何单个 AI 掌握最终答案。
这是在让 AI 模型互相较量中得到的三点经验。当你向多个 AI 问同一个问题时,规律就会浮现。
过去的问题是哪个 AI 模型最好,但这个问题越来越没用了,因为答案会随任务而变。
每一个 AI 模型都有盲点。同时用好几个,就是在盲点造成损失之前把它们找出来。
不同的 AI 会给出不同的答案
答案差异,是指两个模型收到完全相同的提示词后,在假设、推理或事实上的不同。2026 年,哪怕只是一个日常问题,也会出现这种差异,所以不能把一次回答当成定论。这种差异很有用,因为它会显示每个模型悄悄默认了什么,以及你应该在哪里多看两眼。
第一,不同的 AI 会给出不同的答案。经常同时打开 ChatGPT、Claude 和 Gemini 这 3 个标签页,把同一个问题问给三个,并排比较回答。你会看到不同的假设、不同的推理,有时还有不同的事实。这会让你明白,没有任何单个 AI 掌握最终答案。
公平的比较要从公平的设置开始:
相同的提示词,相同的任务,相同的评判者。
不同的答案也不一定更差:
它们给你的见解各不相同,你可以把所有见解放在一起比较。
Gemini 在一个提示词上可能表现出色,到了下一个又出奇地平庸。
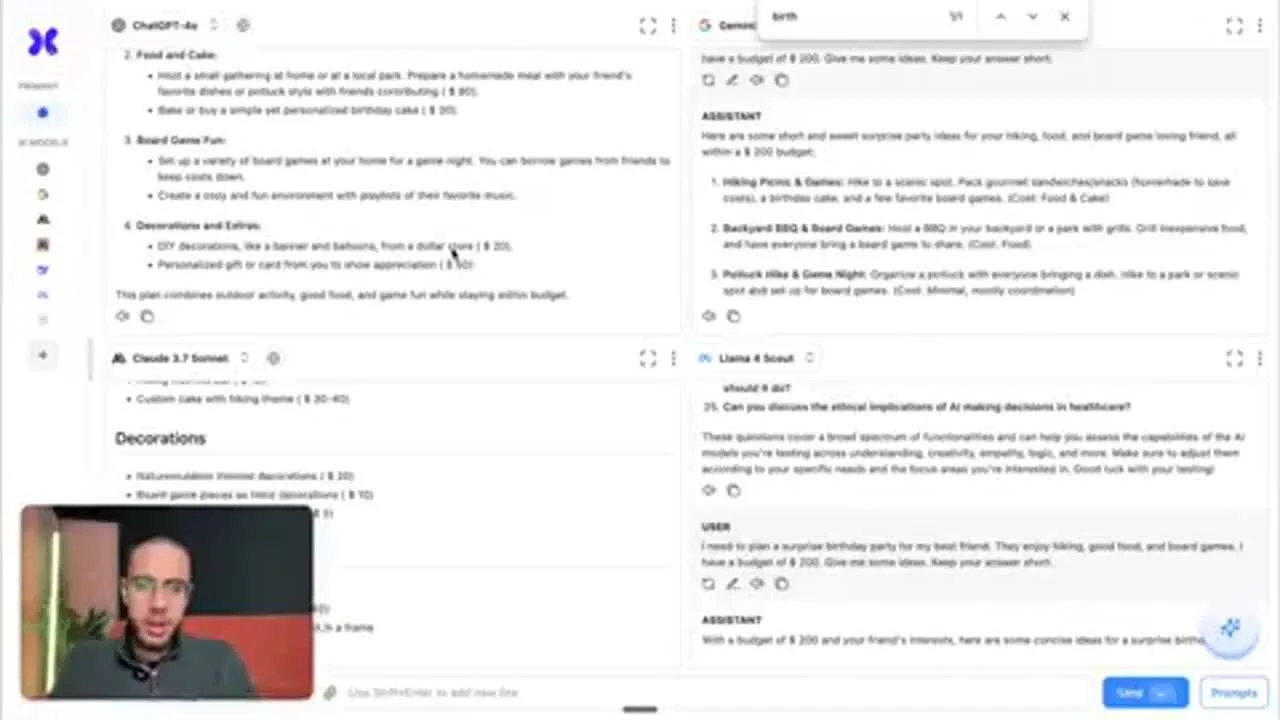
对比多个 AI 模型回答同一提示词的视频画面,2026 年 4 月。
它们一致时,把握就更大
交叉核对,是指用第二个或第三个独立的回答来确认第一个回答。当多个助手给出相近的答案时,你可以更放心地相信它,而 2026 年的这套做法,每个标签页只多花 1 次粘贴。同样的核对能在你行动之前抓出幻觉,对工作问题、旅行计划和日常查询都适用。
第二,当三个都一致时,信心就上升了。把你重要的问题交给多个 AI。如果 ChatGPT、Claude 和 Gemini 给出相似的答案,你就可以更加信任。这种简单的交叉核对能抓出幻觉,给你更可靠的信息。
意见不一致同样有价值:
当三个模型得出同一个答案时,你可以放心地快速推进。当它们意见不一时,那就是让你放慢脚步、在行动之前深入挖掘的信号。
这种分歧其实非常有价值,因为它告诉你,这个问题比看上去更复杂,或者数据不确定,或者存在一个答案无法涵盖的真实模糊性。
每个模型都有自己的风格
模型风格,是指一个助手回答问题时的惯常方式:有多谨慎、多直接、多简短。这是一位测试者在 2026 年的经验法则,不是经过验证的事实,而且每次新版本发布都可能变化。把它当作初步猜测,在依赖它之前,先用你自己的 3 到 4 个问题测试一下。
第三点。这是还没人用起来的一点。每个模型都有自己的风格。Claude 谨慎而详细。ChatGPT 直接而实用。Gemini 简洁而讲事实。让你的问题匹配模型的长处。需要细微差别就用 Claude。需要行动就用 ChatGPT。需要摘要就用 Gemini。
要点很简单:
没有哪个 AI 在所有事情上都是最好的。取得好结果的人会使用多个模型并加以比较。
打开三个标签页,问一个问题,看看有什么不同。
一段对比 AI 模型的短视频画面,2026 年 3 月。
从三个标签页到 Model Council 与 LLM Council
Model Council 是 Perplexity 在 2026 年 2 月推出的功能,可以把一个查询同时发给多个模型。另一个综合模型会审阅各个回答,返回一个结果,显示模型在哪里一致、在哪里分歧,以及只有其中一个发现了什么。LLM Council 是 Andrej Karpathy 在 2025 年 11 月分享的周末项目,分 3 个阶段运行:先收集初步意见,再进行匿名互评,最后由主席模型写出最终答案。
在有这类工具之前,手动流程是这样的:
如果你想要另一个模型的第二意见,就得打开一个新标签页,复制你的提示词,粘贴进去,等待,然后自己手动比较两个答案。这简直是工作流的杀手。
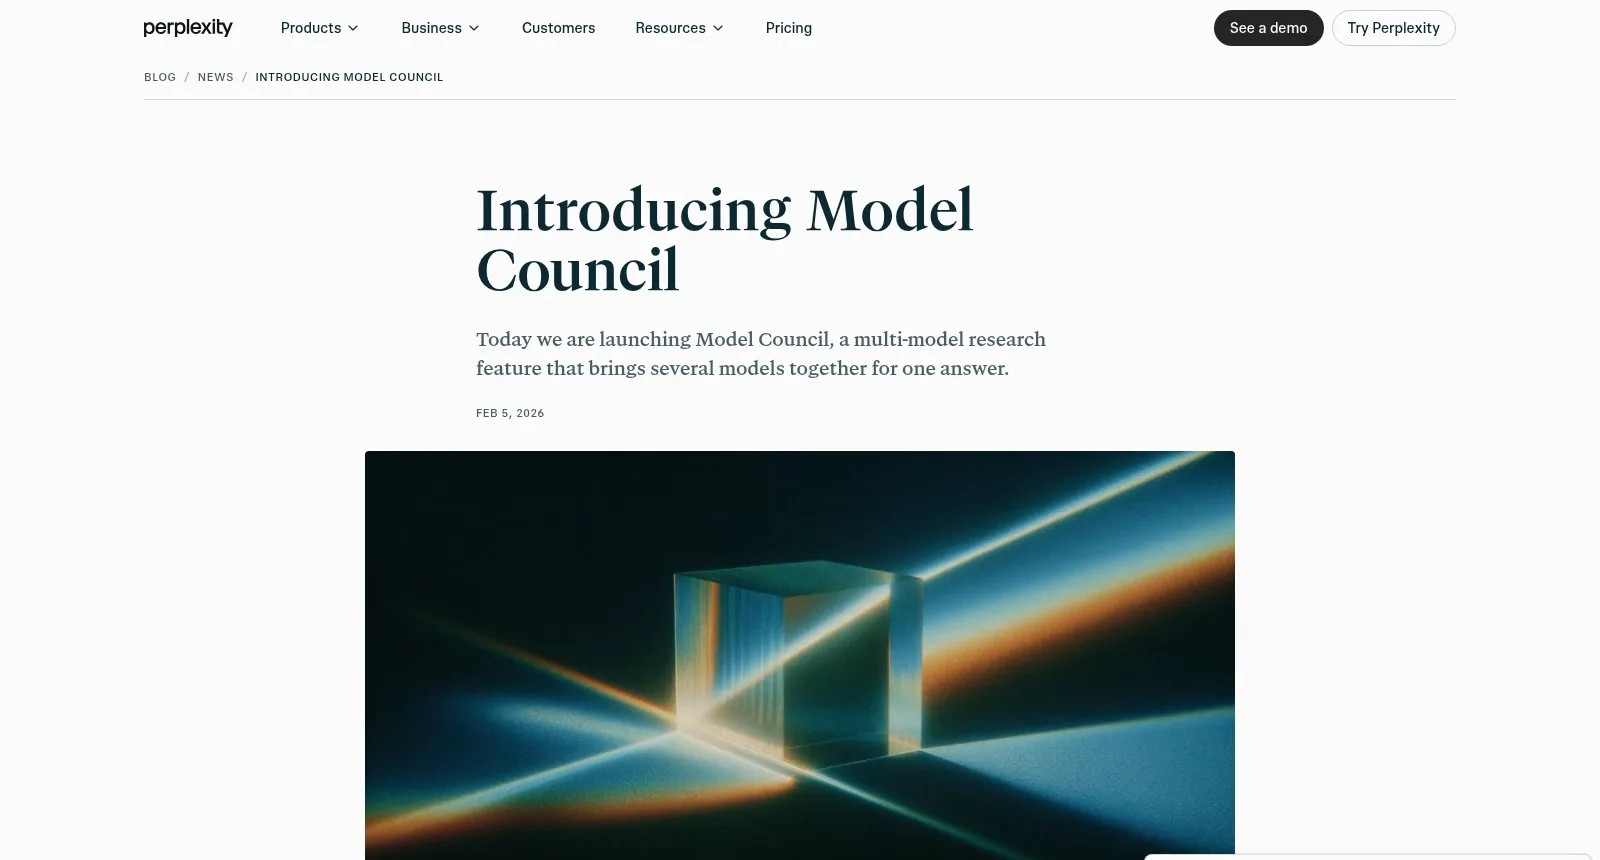
截图:Perplexity 的 Model Council 发布页面,2026 年 2 月。
一步完成的版本是这样运作的:
然后一个综合模型出场,审阅这三份输出,找出它们一致的地方,标出它们分歧的地方,并为你整合成一个清晰、有条理的答案。
与其指望某一个模型答对,不如让三个独立的系统互相交叉核对,由你来三角验证。
你只问一次,就能得到综合后的结果,还能清楚看到哪里把握高,哪里没有把握。
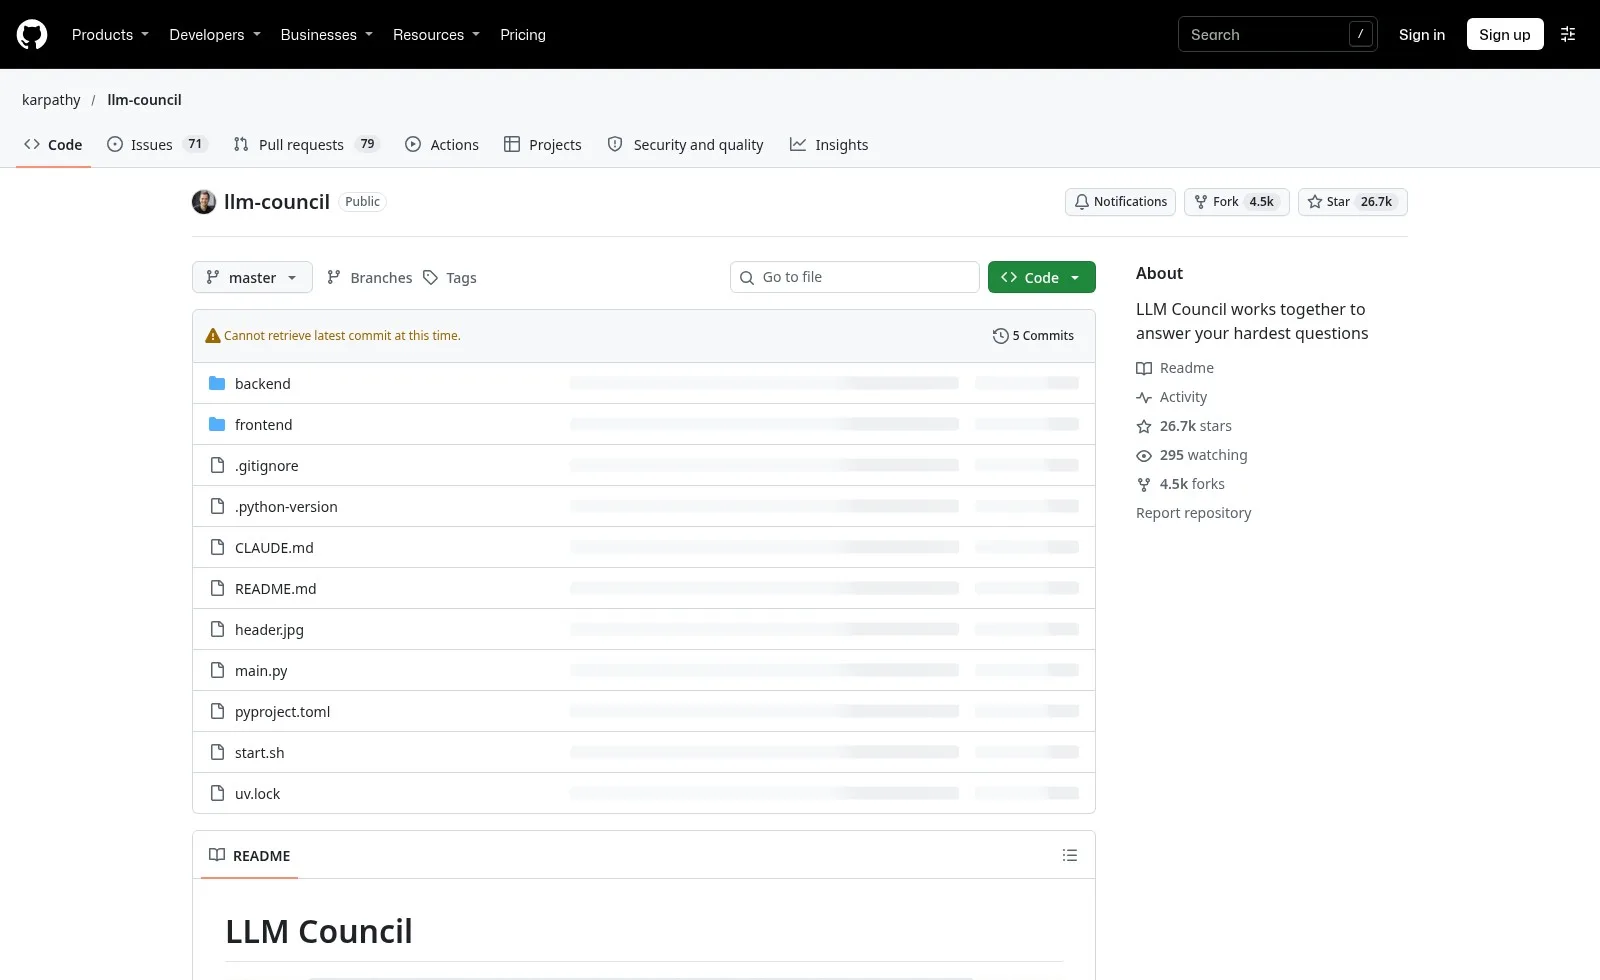
截图:GitHub 上的 karpathy/llm-council 仓库,2026 年 11 月。
让另一个智能体给出第二意见
第二意见工作流,是指由一个 AI 智能体完成工作,再由另一个智能体在相同的项目上下文中进行审阅。2026 年,开发者在 Claude Code 和 Codex 这类编程智能体之间使用这种模式,重要的是交接这个思路,而不是某个具体工具。审阅者从同样的事实出发,带来一双新的眼睛。
假设你从 Claude Code 开始,面对一个真实的支付问题。支付服务商可能在扣款其实已经成功的情况下毫无回应。再扣一次,客户就付了两次。你让 Claude 把这个流程做到可以上线。
到目前为止,这只是一次普通的 Claude Code 会话。但现在来听听第二意见。
Codex 在同一个项目里打开,带着全部上下文。不用复制粘贴,也不用解释 Claude 做了什么。你只要让 Codex 严格审视一下,Codex 就找到了一个真正的问题。
Claude 现在知道了 Codex 里发生的事。你问它怎么看。它清楚问题、修复和理由。它承认 Codex 抓到了一个真正的缺陷。
两个智能体,一个项目,对同一个问题多了一双眼睛。
在 Pachat 中同时聊多个 AI:步骤
Pachat 是 pachat.ai 上的网页产品,官网的描述是“Different personal AI agents, in one group chat.”(不同的个人 AI 智能体,在同一个群聊里。)与其来回切换标签页,不如让你的智能体在群聊里碰面。官方说法:“Put your Claude, Grok Bot, Muse and ChatGPT dots in one group chat. They check each other's facts and argue it out, then you make the call.”
- 打开 pachat.ai。
- 把你的 Claude、Grok Bot、Muse 和 ChatGPT 圆点放进同一个群聊。
- 在群聊里只问一次你的问题。
- 让它们互相核对事实、争论清楚。
- 然后由你来拍板。
想了解产品的使用方法,请阅读AI 群聊指南;想了解背后的基础概念,请看什么是 AI 智能体和 Claude Code 智能体团队。
常见问题
什么是同时聊多个 AI?
同时聊多个 AI,是指把同一个问题问给好几个 AI 助手,并比较它们的回答,而不是只相信一次回复。到 2026 年,你可以用三个浏览器标签页手动对比 ChatGPT、Claude 和 Gemini,也可以用一次运行多个模型的工具,或者用让不同智能体互相交流的群聊。每种做法的目标都一样:发现差异、确认一致之处,并做出更好的决定。
为什么不同的 AI 对同一个问题会给出不同的答案?
不同的模型有不同的假设,遵循不同的推理,有时回忆起的事实也不同,所以同一个提示词可能产生 2 到 3 个不同的答案。2026 年的一位测试者发现,并排比较才是价值所在,因为每个回复都会点出其他回复遗漏的东西。答案之间的差异是让你更仔细阅读的信号,并不是证明某个模型出了问题。
多个 AI 意见一致,就能证明答案正确吗?
不能。意见一致会提高你的信心,但并不能证明答案正确。当 ChatGPT、Claude 和 Gemini 都给出相似的答案时,交叉核对会让幻觉更不容易出现,但数字、日期和产品功能这类重要事实,仍然值得对照原始来源或官方文档再看一眼。用一致来决定推进的速度,用分歧提醒自己在 2026 年以及以后放慢脚步。
哪个 AI 最适合哪种问题?
目前没有经过验证的排名。2026 年的一条经验法则是:Claude 适合需要细微差别的问题,ChatGPT 适合要采取行动的问题,Gemini 适合做摘要,但这只是个人观察,而且模型每次发布都会变化。请用你自己的 3 到 4 个问题,在你使用的几个助手之间测试,记下每项任务更喜欢哪种风格,并持续比较。没有哪个 AI 在所有事情上都是最好的。
Model Council 和 LLM Council 是什么?
Model Council 是 Perplexity 在 2026 年 2 月推出的功能,它把一个查询发给多个模型,再由另一个综合模型合并答案,显示它们在哪里趋同、在哪里分歧。LLM Council 是 Andrej Karpathy 在 2025 年 11 月发布的开源项目:先收集多个模型的初步意见,让它们匿名互相评审,再由主席模型写出最终答案。
不借助任何额外工具,怎样对比 AI 的回答?
在 3 个标签页里分别打开 ChatGPT、Claude 和 Gemini,把同一个提示词粘贴进每一个,然后并排阅读各自的回复。留意假设、推理和事实上的差异,再记下三者一致的地方。2026 年这只需要几分钟,不需要任何设置。如果有一个答案与其他的不一致,在采纳任何一个之前,先让这些助手解释原因。
Pachat 如何融入多个 AI 的聊天?
Pachat 把不同的个人 AI 智能体放进同一个群聊,所以你不必来回切换标签页。根据 pachat.ai 的说明,你把 Claude、Grok Bot、Muse 和 ChatGPT 的圆点放进同一个群聊,它们会互相核对事实、争论清楚,然后由你来拍板。2026 年可以从 pachat.ai 开始体验。
试试 Pachat
在 pachat.ai 把你的 AI 智能体放进同一个群聊。









